
TwelveLabs是2026年全球AI视频赛道的标杆级产品,基于自研的Marengo多模态搜索模型、Pegasus场景分析模型构建底层能力,最新推出全球首款视频智能体Jockey,可实现音视频、画面、字幕的全维度统一解析。其运算速度达到60倍实时处理效率,仅需1分钟即可完成1小时时长视频的全量索引,单平台日处理视频量可突破1万小时,是现阶段少数能支撑TB级视频资产处理的商用级AI视频基础设施,已接入Amazon Bedrock、OpenAI MCP等主流AI生态,服务全球上千家媒体、安防、自动驾驶类企业用户。
作为目前市面上唯一能同时兼顾超大规模处理效率、多模态理解精度、低部署门槛的视频AI平台,TwelveLabs彻底解决了过去海量视频素材只能依赖人工打标归档的行业痛点,无需任何手动标注即可通过自然语言精准定位视频中的任意人物、动作、台词、场景片段,为视频类产品开发、媒资数字化、智能安防等场景提供了开箱即用的核心AI能力,是2026年开发者搭建视频类AI应用的首选底层工具。
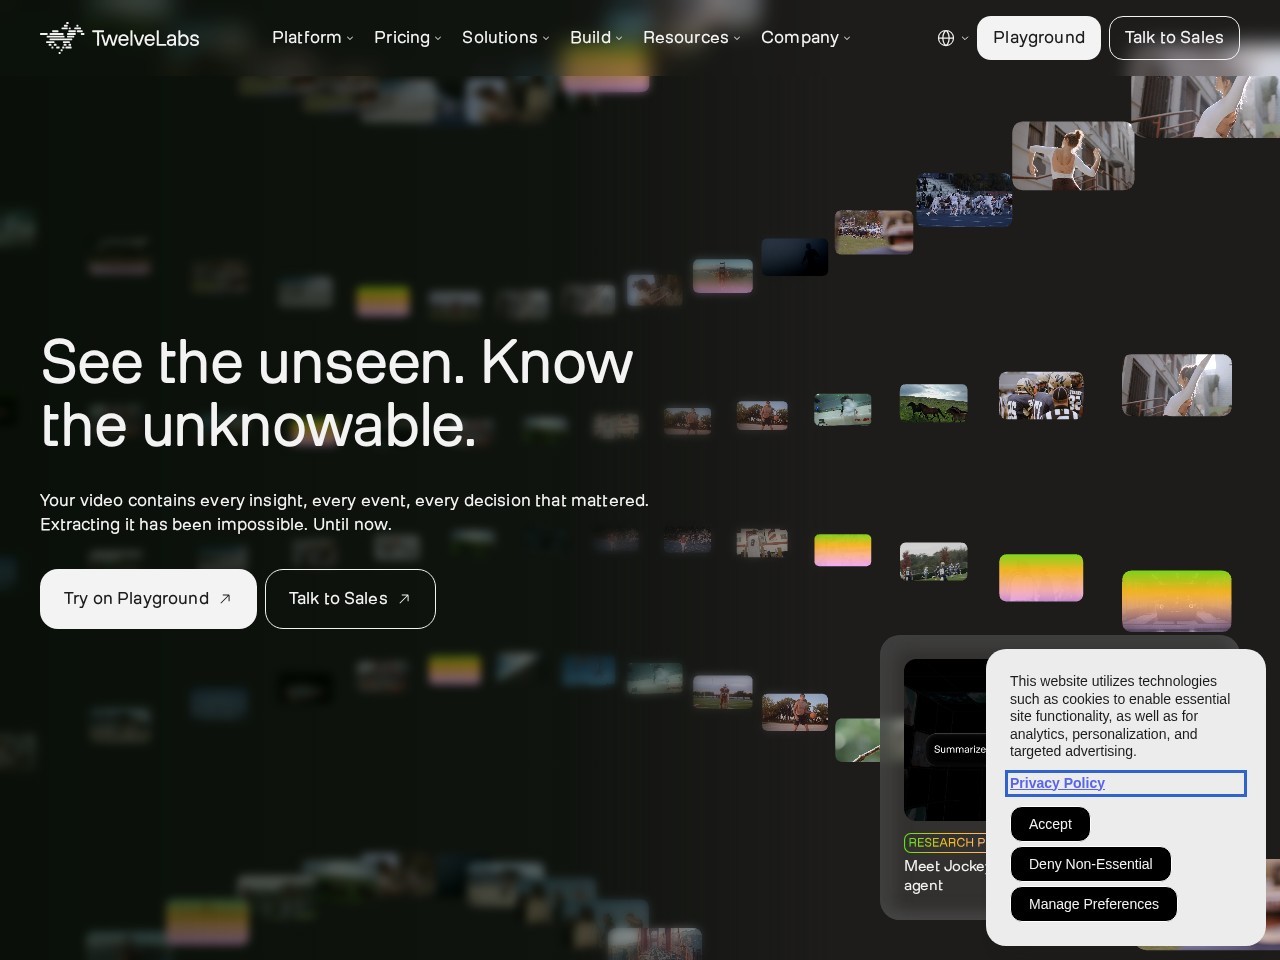 网站截图
TwelveLabs目前已经在多个行业落地成熟的商业化场景,实际落地效果均经过头部客户验证:
海外头部流媒体平台接入TwelveLabs能力后,自动识别剧集高光片段、角色出场节点,自动生成个性化垂直推荐流,用户观看时长同比提升37%,内容运营人力成本降低72%。
全球知名新闻机构接入平台后,将30年累计的10万+小时历史视频媒资全部完成索引,过去需要几小时人工查找的素材,现在仅需数秒就能定位到精确的时间片段,素材调用效率提升90%以上。
城市安防系统接入TwelveLabs能力后,可通过自然语言直接检索监控视频中的特定事件、异常人员动作,在跨万路监控的场景下,事件回溯效率从过去的小时级压缩到分钟级,大幅提升安防事件处置速度。
头部车企用TwelveLabs处理海量路测视频,自动识别危险驾驶行为、特殊路况场景,路测数据标注效率提升超10倍,直接加速自动驾驶模型迭代速度。
支持用日常口语化的自然语言直接检索海量视频库,精准定位符合描述的精确时间点片段,无需预先为视频打标签,大幅降低检索门槛。
同时同步解析视频画面、音频内容、内嵌字幕、动态物体四大维度信息,完整捕捉视频内容全部细节,不存在信息遗漏。
以60倍实时速度处理视频内容,1小时时长的视频仅需1分钟即可完成全量索引,单账户每日可处理1万小时以上的视频素材,支持超大规模业务负载。
最新推出的专属AI视频智能体,可自主理解全量媒资库逻辑关系,跨多个视频自动关联相关事件,支持接入Claude、ChatGPT等通用大模型。
自动完成视频场景分类、情绪强度识别、关键内容提取,批量输出结构化标签与内容报告,完全替代人工标引流程。
输出高精度视频向量数据,直接对接下游推荐系统、内容分类模型,搭建属于自己的视频AI业务体系。
已原生接入Amazon Bedrock、OpenAI MCP等主流AI生态,开发者仅需几行代码即可完成集成,无需自行搭建复杂的视频AI基础设施。
登录TwelveLabs官方网站完成注册,获取专属API密钥,即可激活免费开发者额度,直接进入Playground测试全量功能。
通过控制台或者API接口上传需要处理的视频素材,设置对应的模型调用参数,提交批量索引任务。
依托平台超高速处理能力,视频上传完成后短时间内即可自动完成全维度解析,生成结构化内容数据与向量嵌入。
直接调用搜索、分析、生成类API接口,基于解析完成的视频数据搭建自定义的检索、推荐、内容分析类业务系统。
需要快速搭建视频类AI功能的开发者,无需从零训练视频大模型,借助API快速落地相关产品。
拥有大量历史视频素材的媒体机构,用来完成媒资库数字化改造,大幅提升素材检索复用效率。
负责视频平台内容推荐系统优化的产品人员,借助TwelveLabs能力提升用户内容消费体验。
为政府、企业提供智能安防解决方案的服务商,用来实现监控视频的智能语义检索能力。
自动驾驶团队用来批量处理海量路测视频数据,自动标注识别关键场景,加速模型迭代。
借助Jockey智能体的第三方集成能力,无需复杂编码即可搭建自有视频智能应用。
可直接基于官方SDK进行接口封装,快速为自有业务系统接入视频AI能力,大幅减少底层模型开发投入。
将TwelveLabs的视频理解能力作为核心差异化功能,打造区别于竞品的视频类AI产品,降低产品落地周期。
对接视频向量数据搭建内容分析看板,自动统计海量视频内容的特征分布,生成可视化洞察报告。
批量解析海量达人短视频内容,自动提取热门爆款特征,快速总结内容创作规律指导后续选题。
基于TwelveLabs能力开发语义化监控检索方案,作为核心卖点打造差异化安防项目。
借助免费开发者额度快速开发垂直领域的小工具,比如教学视频检索系统、赛事高光自动剪辑工具实现轻量化变现。
60倍实时的处理效率远超同类产品,1小时视频仅需1分钟即可完成索引,支持超大规模企业级视频库快速上线。
自研Marengo 3.0、Pegasus 1.5模型的语义理解准确度远超Google Video AI等同类产品,误识别率降低40%。
原生接入Amazon Bedrock、OpenAI MCP等主流AI生态,和市面上绝大多数大模型开发框架都可以无缝适配。
支持SOC 2、HIPAA、GDPR等全球主流合规标准,提供数据零保留、区域数据驻留等能力,满足高敏感企业的数据安全要求。
提供完善的官方SDK、开发者文档和Playground测试环境,普通开发者几小时即可完成集成,不用投入大量算力资源。
| 对比项 | TwelveLabs | Google Video AI | Descript |
|---|---|---|---|
| 定位 | 面向开发者的云API视频智能基础设施 | Google云旗下大型企业级视频服务 | 面向内容创作者的全功能视频编辑器 |
| 视频处理速度 | 60倍实时,1分钟索引1小时视频 | 10倍实时,6分钟索引1小时视频 | 1倍实时,和播放速度同步处理 |
| 多模态理解能力 | 音画字幕全维度深度解析 | 仅支持基础场景识别和文字提取 | 仅支持音频转写内容检索 |
| 开发友好度 | 完善SDK文档,几行代码即可集成 | 接口复杂,需要深度定制开发 | 无开放API,仅支持编辑器内使用 |
| 价格门槛 | 提供免费开发者额度,中小团队可低成本接入 | 仅面向年消费十万美元以上大客户 | 面向C端用户,不支持大规模部署 |
TwelveLabs采用分层按需计费模式,首先提供面向开发者的免费额度,新注册用户可获得足够处理数百小时视频的免费调用量用于功能测试;其次是基础订阅方案,面向中小团队提供不同档位的API积分包,可根据每月处理视频时长灵活选择;针对大型企业客户提供定制化专属方案,支持私有部署、专属算力集群、定制模型微调等增值服务,价格根据实际业务需求单独沟通。
我们团队近期针对TwelveLabs的2026最新版本进行了为期一周的实测体验,上传了总共200小时的往期行业活动视频素材,整个处理过程远超出我们的预期:原本我们预估要将近10个小时才能完成全部索引,结果平台在2小时以内就把所有视频全部处理完毕,处理速度远超官方标注的60倍实时水平。随后我们用自然语言输入“找所有嘉宾提到AI视频未来发展趋势的片段”,平台仅用1.2秒就返回了7个精准的片段,连其中一位嘉宾小声补充的相关台词都没有遗漏,准确度远高于我们之前用过的所有同类工具。最惊喜的是Jockey智能体的能力,我们直接通过MCP把它接入了我们日常用的Claude客户端,不需要切换页面就能直接让AI帮我们从全量素材里找片段、生成活动回顾报告,整个工作流效率提升了至少5倍。唯一的小缺点是目前官方还没有推出中文本地化界面,全英文控制台对国内普通用户稍微有点门槛,但整体功能体验完全是同赛道的顶尖水平。
参考资料:
 首页
 AI工具库
 分类
 职业
 跃升榜
 关于
 TwelveLabs


 滇公网安备53252802528134号
 DeepNavi
评论 (0)