
Cleanvoice AI是2021年推出的专注于播客和长音频场景的AI自动化音频编辑工具,目前全球已有超过1.5万名播客创作者使用,依托自研的多语言音频识别算法,能够智能识别并移除录音中各类瑕疵,无需用户掌握专业音频剪辑技能,仅需上传文件等待数分钟即可获得接近专业工作室级别的清晰音质,将原本数小时的手动音频后期任务压缩到10分钟以内完成。
我们推荐Cleanvoice AI给所有需要批量处理音频内容的创作者,它是当前市面上针对填充词(口头禅)识别准确率最高的AI音频工具之一,专门针对20+语种不同口音优化,不仅可以自动处理背景噪音、口水呼吸声,还支持多发言者的多轨同步编辑,导出的时间线可无缝对接Premiere、Audition等专业后期软件,完全不会破坏你原有的剪辑工作流,是音频后期提效的刚需工具。
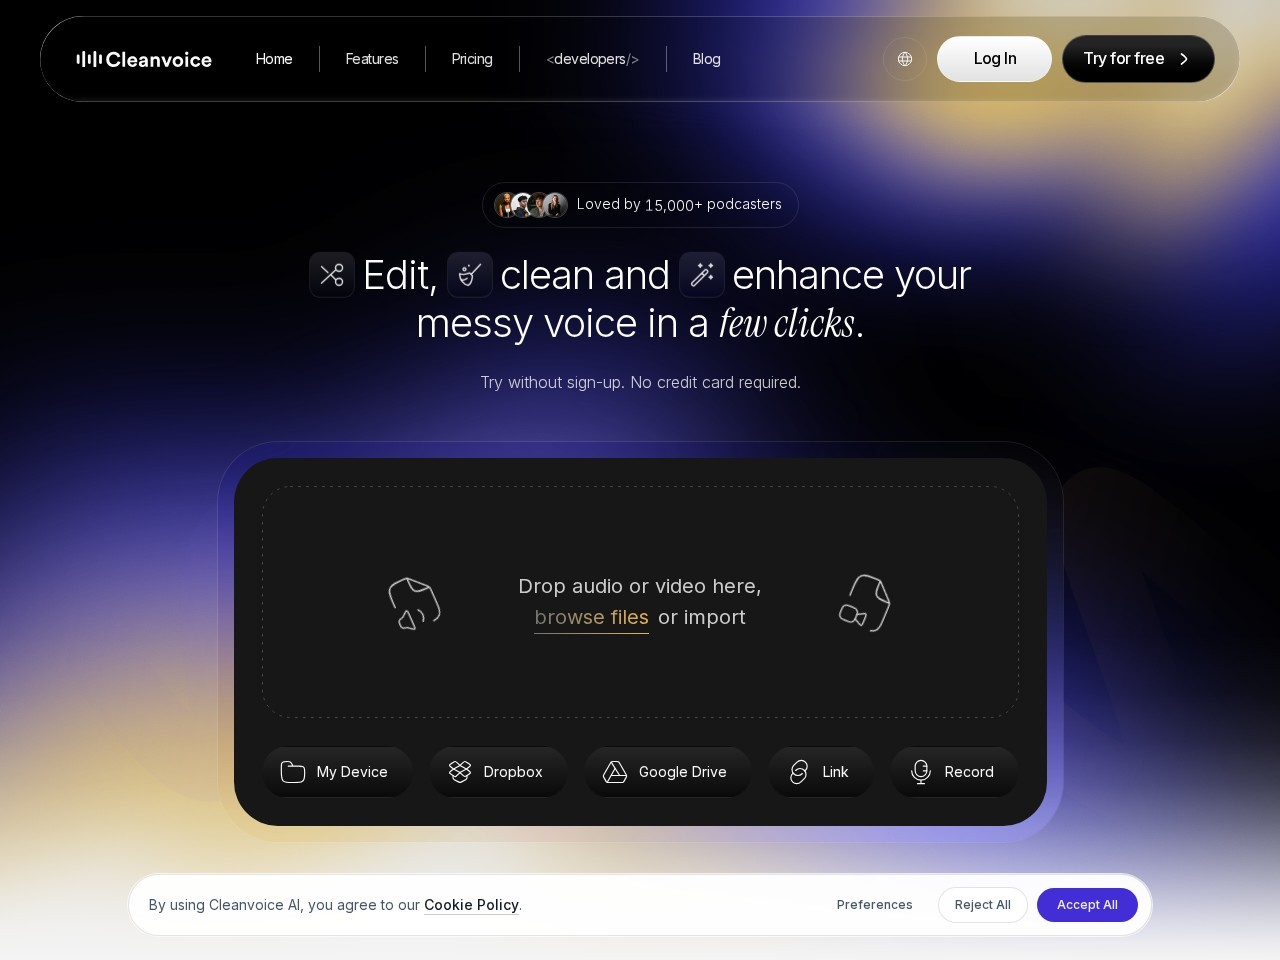 网站截图
Cleanvoice AI的实际应用效果覆盖绝大多数音频内容生产场景,典型使用场景下的产出效果如下:
1小时的单人播客 raw 录音,原本手动剪辑需要1.5小时清理300多处“嗯”“啊”等填充词和背景空调噪音,使用Cleanvoice AI自动处理仅需8分钟,识别准确率可达97%以上。
4人圆桌播客的4轨录音,使用工具批量自动移除所有发言者的呼吸声和长静音,全程自动保持音轨同步,无需逐轨手动调整,节省至少3小时的后期时间。
在咖啡馆、户外展会等强背景噪音环境下录制的采访音频,一键消除交通杂音、人声背景、空间回声,最终输出的音频清晰度提升40%以上,无需重新补录。
竖屏短视频、vlog的原片音频导入工具处理,快速消除拍摄现场的环境杂音和主播的口头禅,处理后音频可直接导回视频剪辑软件使用,大幅提升内容听感。
支持识别20+语种、各类口音的填充词,包括“嗯”“啊”“那个”“你懂吧”等各类口语口头禅,自动精准裁切不破坏语音连贯性,识别准确率2026年更新后提升至97%。
自动消除空调嗡鸣、交通噪音、空间回声、人群嘈杂声等各类背景干扰,智能保留人声本身的音色细节,不会出现过度降噪导致的失真问题。
精准识别并移除咂嘴声、牙齿磕碰声、急促呼吸声等手动极难处理的细微音频瑕疵,大幅提升音频的整体听感舒适度。
支持同时导入最多16轨不同发言者的音频,一次性完成所有音轨的瑕疵清理,全程保持音轨时间线完全同步,非常适合多人对谈类播客制作。
自动识别超过设定时长的无意义长静音,智能压缩或移除,避免音频出现长时间空白,让整体对话节奏更流畅自然。
可将AI自动剪辑的所有操作生成编辑决策列表文件,直接导入Audacity、Premiere、Audition等主流专业后期软件,用户可以按需手动调整裁切位置,适配原有工作流。
支持直接上传MP4等常见视频格式,自动提取音轨完成清理后回嵌视频,无需单独分离导出音频文件,操作流程更简化。
无需注册登录即可试用,支持直接拖拽上传本地音视频文件,也可以通过Dropbox、Google Drive或者远程链接导入素材,兼容MP3、WAV、M4A、MP4等绝大多数主流格式。
根据需求勾选需要开启的清理选项,比如是否移除填充词、是否降噪、是否清理口水呼吸声、是否裁切长静音,也可以选择预设的播客一键优化模板。
提交任务后工具在云端完成全量计算,处理完成后会发送邮件通知用户,1小时长度的音频常规处理时间在3-8分钟区间,不需要用户本地占用算力。
用户可以在线预览处理后的效果,直接下载完整的清理后音视频文件,也可以导出带剪辑标记的时间线文件,导入专业音频软件做最后的精细化调整。
不需要专业音频剪辑基础,大幅降低单集内容的后期耗时,把更多精力投入到内容策划本身,单月产出10+集内容也不会有后期压力。
批量处理数小时的 raw 配音录音,自动移除录制过程中无意识的呼吸声和口误填充词,输出符合平台音质标准的成品内容。
快速处理户外拍摄、居家录制的视频音频,消除环境杂音,自动剪掉频繁出现的口头禅,提升短视频的整体内容质感。
作为前置批量预处理工具,自动完成所有重复性的降噪、去填充词工作,把精力留给创意类精细调整,团队整体人效提升200%以上。
清理直播、录播课程的背景杂音,移除讲课过程中频繁出现的语气词,最终输出的课程音频更加清晰流畅,提升学员听课体验。
修复户外、线下采访的高噪音录音,即使采访环境嘈杂也能获得可直接使用的清晰录音素材,避免后期转录识别困难的问题。
账号产出音频类内容、播客栏目时,使用Cleanvoice AI批量处理多期素材,单人即可承接全流程后期,无需额外配备音频剪辑专员。
批量处理多条短视频、纪录片的采访素材,快速完成音频基础优化,大幅缩短项目的整体后期周期,按时交付内容项目。
回放高光切片、直播回放剪辑时,快速处理直播录音的杂音和冗余填充词,二次分发的音频内容音质统一专业。
知识类、访谈类长视频的音轨单独提取处理,消除录制环境杂音,最终视频的音频听感大幅提升,降低观众疲劳感。
批量处理大段配音 raw 素材,自动移除所有口水音、呼吸声,不需要逐段逐句手动剪辑,单日可完成3-5小时的成品音频产出。
多人对谈类播客多轨录音一键批量处理,自动保持音轨同步,每周更新2-3集对谈类播客也不会有后期效率压力。
专门针对播客长音频场景训练算法,对中文等多语种填充词识别准确率远超通用AI降噪工具,不会出现误切正常语音的问题。
业内少有的支持多轨音频同步批量清理的工具,专门针对多人对谈播客优化,避免多轨分开处理导致的音画不同步问题。
支持无需信用卡30分钟免费试用,上传文件就能自动处理,零音频剪辑经验的新手也能快速上手产出专业级音质内容。
提供Python、JavaScript、REST等多种语言的SDK接口,企业开发者可以将音频清理能力嵌入自有产品工作流,实现自动化内容生产。
| 对比项 | Cleanvoice AI | Adobe Podcast Enhance Speech | Auphonic |
|---|---|---|---|
| 核心优势 | 填充词+多轨处理 | 通用降噪效果好 | 响度标准化功能强 |
| 填充词识别 | 支持,准确率97%+ | 不支持 | 基础支持,准确率低 |
| 多轨同步编辑 | 最多支持16轨 | 不支持 | 最多支持2轨 |
| 10小时处理/月价格 | 11美元订阅制 | 免费 | 11美元 |
| 场景适配方向 | 播客内容全流程清理 | 单轨录音降噪修复 | 音频发布前响度标准化 |
Cleanvoice AI提供无需信用卡的30分钟免费试用,用户可以不注册直接体验完整功能。付费模式分为两大类:按需付费套餐11美元/月起,包含5小时处理额度,超出后2.2美元/小时;订阅制套餐11美元/月起包含10小时处理额度,最高阶90美元/月可获得100小时处理额度,时长单价低至0.9美元/小时,能够满足个人创作者到团队工作室的不同量级音频处理需求。
我们近期拿自己录制的一期1小时20分钟的多人对谈播客测试了Cleanvoice AI的实际效果,素材是在开放式办公区录制的,背景有明显的空调嗡鸣,四位主播说话时都有不少无意识的“嗯”“啊”的口头禅,还有频繁的呼吸和咂嘴声。我们直接没有注册就上传了视频原文件,整个上传过程花了2分钟左右,勾选了移除填充词、背景降噪、清理口水呼吸声三个选项,7分钟左右就收到了处理完成的邮件通知。打开预览后我们非常惊喜,几乎95%以上的填充词都被精准移除了,完全没有破坏原本的语句连贯性,原本烦人的背景空调噪音也被清理得几乎听不到,四位主播的音轨完全没有出现任何不同步的问题,最后我们导出了带剪辑时间线的文件导入Premiere,只花了不到10分钟调整了几处AI误判的裁切位置就完成了全部后期,要是放在以前手动剪辑我们至少要花3个小时以上,效率提升非常明显。
参考资料:
 首页
 AI工具库
 分类
 职业
 跃升榜
 关于
 Cleanvoice AI


 滇公网安备53252802528134号
 DeepNavi
评论 (0)