
Voicemaker是海外头部AI文字转语音音频生成平台,基于最新的深度神经网络语音模型打造,累计为全球超200万创作者提供音频生成服务。平台覆盖140+语种、1000+不同风格的AI人声,除基础文本转语音能力外,还集成了语音克隆、语音转语音、音频降噪增强、自动字幕生成等全链路音频处理功能,无需切换多个工具即可一站式完成从文字到最终商用音频的全流程制作,大幅降低音频创作门槛。
Voicemaker是当前市面上语音自然度表现第一梯队的TTS工具,2026年最新上线的ProPlus高分辨率语音模型,生成效果几乎无法区分AI与真人录制,同时支持单账号批量处理十万字级别的长文本内容,商用授权规则清晰无版权风险,是内容创作者、企业用户制作批量配音内容的高性价比选择,尤其适合多语种跨境内容创作场景。
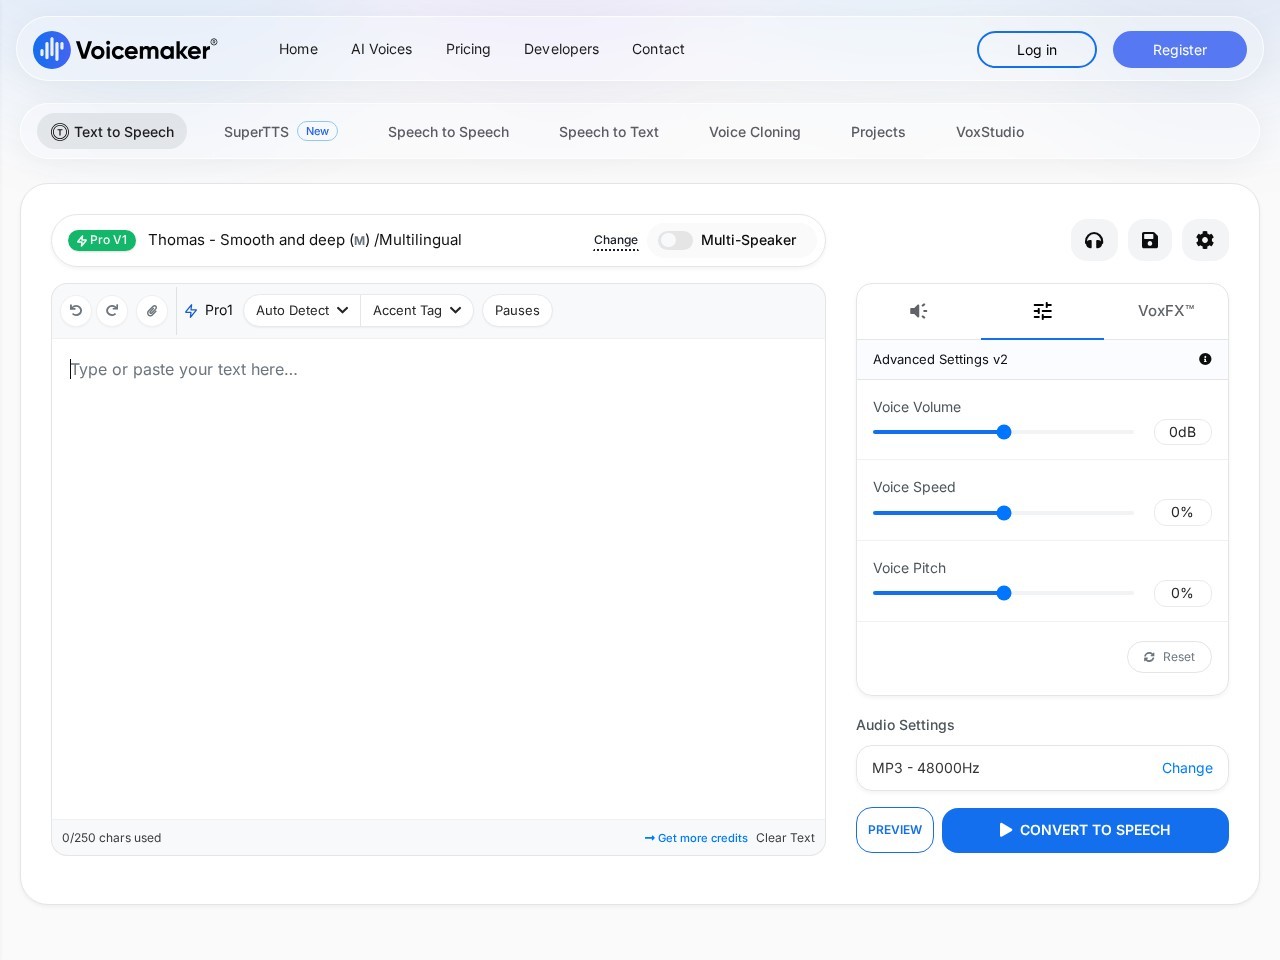 网站截图
以下是Voicemaker在不同创作场景下的实测产出效果:
输入1200字抖音带货文案,选择活力中文女声,生成85秒音频,语速节奏完全适配短视频传播规律,无任何机械感,导入剪辑软件直接可使用。
导入5万字网络小说片段,选择沉稳叙事男声,一键生成完整音频包,自动在段落间设置合适停顿,整体听感流畅富有情绪起伏,媲美专业配音员录制效果。
上传中文电商产品介绍文案,一键生成英语、西班牙语、阿拉伯语等6种不同语种的配音,所有语音符合对应地区本土表达习惯,适配不同区域海外短视频平台发布。
上传3段用户本人1分钟清晰录音,10分钟完成语音克隆,生成完全匹配个人声线的AI语音,后续所有内容配音都可以保持个人声音一致性,打造专属品牌IP声效。
覆盖140+国家和地区语种,提供1000+不同性别、年龄、风格的AI人声,包含动画角色、新闻播报、叙事故事、社交娱乐等多个分类,适配所有配音场景需求。
通过交互式滑块精准调节语速、音高、停顿时长,支持针对感叹号、问号、井号等不同符号单独设置停顿时长,还可手动修改特殊专业术语、小众词汇的发音规则。
生成音频的同时自动对齐生成SRT格式字幕文件和纯文本文字稿,时间轴准确率可达98%以上,无需额外手动制作字幕,直接导入剪辑软件即可使用。
仅需上传3-5段无背景噪音的清晰人声样本,短时间内即可训练出1:1还原原始声线的专属语音模型,支持多情绪切换,满足品牌定制声线、虚拟主播等需求。
内置AI降噪算法,自动清除背景杂音、回声、电流音,可将手机录制的低质量音频一键升级为录音室级高清音质,同时支持人声分离功能快速提取歌曲中的人声内容。
导出MP3音频时自动将语音属性、生成时间、内容标签等信息写入ID3元数据,方便用户批量管理海量音频素材,提升内容库整理效率。
完全兼容W3C标准的SSML标记语言,支持开发者通过代码自定义复杂的重音切换、发音跳转、多语种混读等效果,适配企业级定制开发需求。
访问Voicemaker官方网站,通过邮箱完成注册,免费用户即可体验全部样音试听功能,企业用户支持SSO单点登录直接导入团队账号。
在语音库中筛选匹配需求的语种、风格人声,通过调节滑块自定义语速、音高、全局停顿时长,通过发音编辑器修正特殊词汇的读音。
粘贴需要转换的文字内容,系统自动统计字符数和预计生成时长,长文本无需分段可直接全部导入,支持单次最高10万字文本提交。
点击生成按钮后等待几秒即可完成音频渲染,可按需下载320kbps MP3、无损WAV格式音频,同时同步导出配套的SRT字幕文件。
可以快速批量生成不同风格的口播配音,替代传统高价真人配音,将视频制作周期从几小时压缩到几分钟。
支持十万字级长文本一次性生成,无需分段处理,大幅提升长篇音频内容的产出效率,降低制作成本。
一键生成数十种不同语种的本地化配音,无需找多个不同国家的配音员,大幅降低海外内容制作成本。
快速生成标准清晰的课程讲解音频,适配语言学习、技能培训等各类教育场景,提升课程制作效率。
企业客服运维人员
快速批量制作智能导航语音、活动播报话术,自定义品牌专属声线,提升用户服务体验。
快速生成内容旁白、转场音效素材,搭配音频增强功能修复低质量录音,提升最终播客成品音质。
日常剪辑中可以用Voicemaker批量生成不同风格的口播配音,配合自动字幕功能,单条视频后期制作时间可缩短60%以上,大幅提升日产出量。
快速产出多版本热点内容音频,一天可制作数十条不同主题的短视频配音,提升账号更新频率,放大内容矩阵传播效果。
可以用自己的声线完成语音克隆,生成专属AI配音助手,快速产出作品初稿,再进行少量人工优化,把月产出能力提升3倍以上。
一键生成多语种产品介绍音频,适配TikTok、YouTube等海外平台的内容发布需求,快速搭建多语种海外账号矩阵。
制作在线课程时,把课件文案直接导入生成标准清晰的讲解音频,无需反复录制,避免口音、口误问题,大幅提升课程出品质量。
将Voicemaker作为辅助工具快速生成多个配音样稿,给到客户试听选择,确定最终风格后再投入真人录制,大幅降低沟通和试错成本。
2026年最新的ProPlus高分辨率神经语音模型,生成音频拟人度超过97%,几乎无法辨别是AI生成内容,远高于行业平均水平。
行业领先的十万字级单文本生成能力,无需拆分分段上传,完全适配长篇小说、课程合集等超大量音频制作场景。
从文本转语音、语音克隆到音频增强、自动字幕生成一站式完成,无需同时搭配多个工具,学习成本低,上手效率高。
所有付费订阅用户生成的音频都拥有完整永久商用授权,没有版权纠纷风险,可随意用于各类公开商业传播场景。
| 对比项 | Voicemaker | 国内某主流TTS工具 | Google TTS |
|---|---|---|---|
| 可用语音数量 | 1000+ | 300+ | 200+ |
| 支持语种数量 | 140+ | 30+ | 100+ |
| 长文本单文件上限 | 10万字 | 1万字 | 5000字 |
| 语音克隆功能 | 支持 | 支持 | 不支持 |
| 商用授权 | 完整永久商用 | 仅限非独家商用 | 商用需单独申请 |
Voicemaker采用分层付费体系:免费版用户每月可获得最多10分钟音频生成额度,可试听全部样音效果;付费订阅档位分为四个层级,入门版5美元/月含100分钟生成时长,专业版15美元/月含1000分钟生成时长,高级版30美元/月支持无限量音频生成,企业版提供定制报价,支持团队账号管理、专属语音库私有部署、API对接等定制服务,完全匹配不同规模用户的使用需求。
我们近期完整实测了2026年最新版本的Voicemaker工具,整体使用体验远超预期。注册完成后我们先试用了免费额度,上传了一段2000字的抖音带货文案,选择中文活力女声后只用了不到10秒就完成了音频生成,听感上几乎完全没有传统AI配音的机械卡顿感,语气起伏自然流畅,完全可以直接用于短视频发布。随后我们测试了发音自定义功能,输入了几个生物医药领域的专业术语,手动调整读音后,生成的音频没有出现任何读错字的情况。最惊喜的是十万字级长文本生成功能,我们导入了一部3万多字的短篇有声书全文,没有做任何分段处理直接提交,全程没有出现报错,生成的音频段落间停顿节奏自然,搭配自动生成的SRT字幕,我们原本预计要3小时完成的配音+字幕工作,只用了不到20分钟就全部做完。对比我们之前测试过的十多款同类TTS工具,Voicemaker在语音自然度和长文本稳定性上的表现绝对属于第一梯队,非常适合有大量配音需求的内容团队使用。
参考资料:
 首页
 AI工具库
 分类
 职业
 跃升榜
 关于


 滇公网安备53252802528134号
 DeepNavi
评论 (0)