
Browse AI是2026年行业认可度极高的无代码AI网页数据采集平台,全球累计服务超77万用户,凭借零代码操作逻辑、低反爬阻断率、7000+第三方应用集成能力,成为非技术人员快速获取全网公开数据的首选工具。平台内置250+预配置采集机器人,覆盖电商、房产、招聘、法律等多个垂直场景,用户无需编写爬虫代码,仅需通过可视化拖拽+自然语言指令,就能在几分钟内生成自定义采集任务,同时支持网页异动实时告警、结构化数据自动导出等全链路服务。
我们认为Browse AI是当前市面上对非开发者最友好的AI爬虫工具,完全避开了传统网页采集需要学习正则表达式、应对反爬机制、维护代理池等高门槛环节,普通运营、市场人员也能在10分钟内搭建完成高稳定性的数据采集任务,相比手动复制粘贴效率提升至少10倍以上,2026年最新评测显示其网页爬取成功率高达91%,远高于同类平均78%的水准。
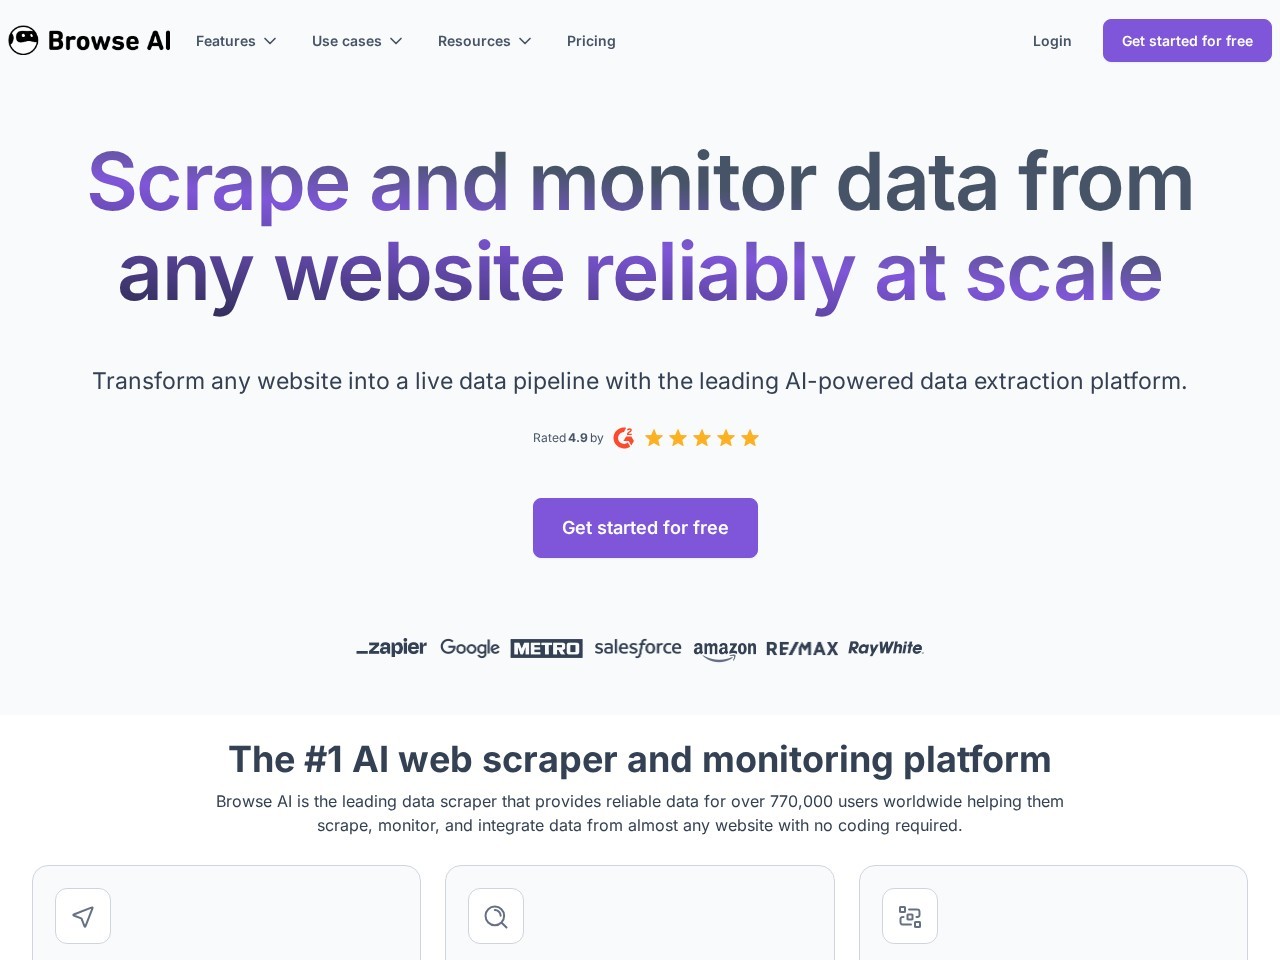 网站截图
Browse AI在不同业务场景下均有成熟落地案例,以下是4类典型使用效果参考:
跨境电商从业者配置竞品监控任务,每日自动抓取亚马逊上120款竞品的价格、库存、评分数据,同步到Google Sheets自动生成价格预警线,单月节省人工统计时长超30小时,定价策略调整响应速度提升60%。
房产中介批量爬取12个城市主流二手房平台的挂牌房源数据,自动过滤重复房源、价格异动超过5%的标的实时推送通知,获客线索量提升45%,无效人工筛选成本降低70%。
人力资源公司监控200+企业招聘官网的岗位更新情况,一旦出现符合岗位要求的新发布职位立刻同步到团队飞书群,比传统手动刷新抢简历快2小时以上。
SEO运营人员监控1000+竞品网站的内容更新、外链变动、排名波动数据,自动生成周度行业SEO趋势报告,无需人工逐站核查,报告产出效率从48小时压缩到15分钟。
依托AI自动识别网页内容结构,无需手动配置选择器,支持无限滚动、分页、登录态等复杂页面采集,自动绕过主流反爬机制,爬取成功率超90%。
一键将任意网页的结构化数据转化为Google Sheets、Airtable格式的在线表格,数据自动实时同步,不需要手动导出导入文件。
支持自定义监控规则,网页内容发生指定幅度变动时自动触发邮件、webhook告警,实时掌握竞品、行业站点的信息更新动态。
几分钟内将任意网页转化为标准化可用API接口,返回结构化JSON格式数据,可直接对接自有业务系统,无需后端开发介入。
通过Zapier原生集成几乎所有主流办公、SaaS工具,采集到的数据可自动同步到Notion、飞书、Salesforce等平台,打通数据全链路流转。
内置覆盖电商、房产、招聘、法律、社媒等主流平台的现成采集模板,开箱即用,不需要从零开始配置任务。
针对企业级复杂采集需求,提供全托管专业爬虫部署服务,由平台技术团队负责维护爬虫稳定性、应对反爬、处理数据清洗等全部环节。
使用邮箱注册Browse AI平台账号,在控制台选择新建自定义采集任务,输入需要爬取的目标网站URL。
打开目标网页可视化界面,直接点选需要采集的文本、图片、链接等字段,平台AI自动生成对应的采集机器人。
自定义任务运行频率、分页规则、监控触发阈值,配置数据变动后的通知推送渠道,完成任务参数设置。
启动采集任务,平台云端自动完成数据爬取、去重、结构化处理,支持导出为表格/JSON,也可自动同步到已绑定的第三方应用。
不会写Python爬虫的电商、新媒体、SEO运营,零门槛快速获取全网公开数据,不需要依赖技术团队支持。
需要实时监测全平台竞品价格、库存、活动信息,快速调整自身销售策略,提升市场竞争力。
快速批量获取外部行业公开数据,补充内部数据维度,高效完成行业分析、市场调研工作。
批量从企业黄页、行业平台自动提取潜在客户联系方式,生成精准销售线索池。
监控行业站点内容更新、关键词排名变动,快速追踪热点选题,产出时效性高的原创内容。
自动化采集竞品官网、评测平台的用户反馈、功能更新信息,低成本完成竞品追踪工作。
用Browse AI批量采集竞品站点排名、外链、内容更新数据,每天定时跑任务生成SEO优化报表,大幅提升站点迭代效率。
监控全渠道投放素材排名、同行出价变动,自动抓取搜索结果页关键词排名数据,替代人工批量查询,节省至少60%数据统计时间。
配置全渠道竞品商品监控任务,一旦竞品降价或推出新活动立刻收到告警,第一时间调整运营策略,避免流量流失。
将采集到的行业数据自动同步到数据看板,无需手动导入导出,自动生成周度/月度行业运营分析报告。
通过网页转API功能直接对接分析平台,获取的外部数据不需要二次处理,直接就能用于建模和可视化分析。
批量采集小红书、抖音等平台的垂直领域博主联系方式,自动过滤无效账号,快速搭建KOL合作线索库。
完全不需要编程基础,通过可视化点选就能配置完成复杂采集任务,普通用户10分钟就能上手使用,学习成本几乎为零。
平台内置代理池、请求频率自适应调整、UA轮换等反爬对抗机制,2026年实测爬取成功率高达91%,远超同类平均78%水准。
原生支持7000+第三方SaaS工具对接,采集到的数据可以自动流转到各类业务系统,不需要做额外开发打通链路。
所有采集任务都在平台云端运行,不需要本地设备一直开机,任务中断后自动续跑,完全不占用本地电脑算力。
250+各行业头部站点的预制采集机器人开箱即用,不需要反复测试调整配置,新建任务直接套用模板即可产出数据。
| 对比项 | Browse AI | Octoparse | Scrapy |
|---|---|---|---|
| 入门门槛 | 极低,完全零代码 | 中等,需要学习可视化配置逻辑 | 极高,需要掌握Python编程技术 |
| 爬取成功率 | 约91%,内置智能反爬机制 | 约76%,需手动配置代理规则 | 取决于开发者技术水平,平均约65% |
| 集成能力 | 支持7000+应用一键对接 | 仅支持基础格式导出,需手动二次上传 | 需要自行开发代码对接第三方工具 |
| 部署方式 | 全云端运行,不需要本地安装 | 需要下载客户端,本地运行消耗资源 | 本地部署开发环境,服务器运维成本高 |
| 付费门槛 | 永久免费版可用,39美元/月起 | 免费版功能限制多,75美元/月起 | 完全开源免费,但开发人力成本极高 |
Browse AI采用免费增值定价体系:1. 永久免费版:每个月支持100次 credits 采集任务,单任务最多爬取100行数据,可满足个人用户轻度使用需求;2. 入门付费版39美元/月,支持每月2000 credits,无单任务行数限制,解锁全集成功能;3. 专业版99美元/月,提供更高采集额度和专属反爬节点;4. 定制企业版:按需报价,提供专属技术支持、私有部署、全托管采集服务。同时年付用户可享受8折优惠。
我们本次实际注册使用了Browse AI免费版进行测试,整个流程的顺畅度远超我们的预期:输入一个主流电商商品列表页的URL之后,平台自动识别页面结构,我们仅用鼠标点选了商品名称、价格、销量、链接这四个字段,不到3分钟就生成了专属的采集机器人,运行后很快就返回了200行带完整字段的结构化数据,完全不需要我们手动写任何一行代码。之后我们又配置了一个监控任务,设置当商品价格下降超过10%时发送邮件告警,测试触发规则后,告警邮件在2秒内就收到了,响应速度非常快。对比我们之前用过的其他同类无代码爬虫工具,Browse AI的反爬表现尤其突出,测试了3个设置了较强反爬机制的站点,全部都一次性爬取成功没有出现阻断报错,整体体验非常丝滑,完全对得起4.5/5的用户评分。
参考资料:
 首页
 AI工具库
 分类
 职业
 跃升榜
 关于
 Browse AI

 滇公网安备53252802528134号
 DeepNavi
评论 (0)