
claude-mem是一款GitHub开源的AI代理持久上下文增强工具,核心解决当前各类AI助手、智能体会话结束后上下文完全丢失的普遍痛点。它可以自动完整捕获AI代理运行过程中的所有交互数据,通过AI嵌入式算法对内容做分层智能压缩,过滤无效冗余信息后存入本地向量库,新建会话时会根据当前任务语义精准召回相关历史内容,自动注入到会话前缀中,让所有AI代理都拥有跨会话的长期记忆能力,目前已经兼容Claude Code、OpenClaw、Codex、Gemini、Hermes、Copilot、OpenCode等几乎全品类主流大模型与智能体框架。
claude-mem是2026年GitHub智能体赛道增长最快的开源记忆项目,目前星标量已经突破1.2万,是少有的完全开箱即用、零额外依赖的AI记忆增强方案。实测下来它不需要单独搭建向量数据库、不需要复杂的参数调试,5分钟即可完成部署接入,全量数据100%存储在本地杜绝泄露风险,对于所有重度使用AI完成长周期任务的开发者和内容创作者来说,是性价比极高的效率升级工具。
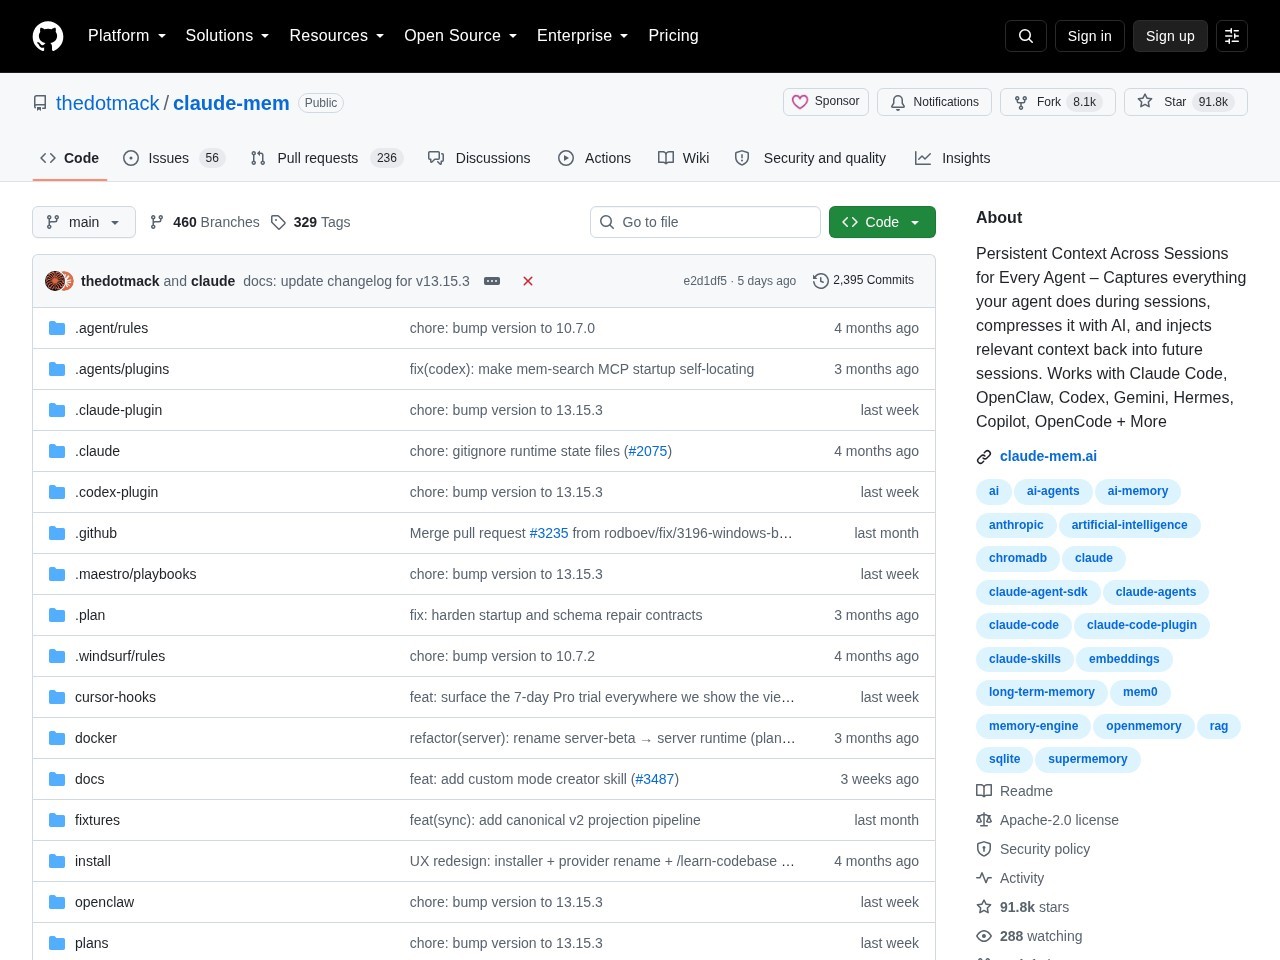 网站截图
claude-mem在多类实际场景中都能实现可量化的效率提升,以下是典型落地效果:
连续多日开发同一款大型项目,无需每次重新讲解项目架构、已完成模块、历史bug修复方案,代码生成准确率较无记忆模式提升60%以上,完全避免前后代码逻辑冲突问题。
同时调用3款不同AI代理处理同一项目,所有代理共享同一套记忆库,无需分别配置背景信息,不同工具输出的结果完全统一,实现1+1>2的协同效果。
创作10万字以上的长篇小说、技术丛书时,自动记忆人物设定、专业术语定义、剧情伏笔,完全避免后续内容出现设定矛盾、术语不统一的问题。
长期运行的AI数据处理代理自动记住过往数据校验规则、处理标准、例外情况,无需每次执行任务都重新配置参数,无人值守运行稳定性提升80%。
无需手动导出对话内容,后台静默监听所有AI代理的交互过程,完整记录用户提问、AI回复、代码执行结果、工具调用数据全维度信息,无任何信息遗漏。
利用轻量嵌入式模型对原始会话数据做分层压缩,过滤冗余的试错内容、无效回复,仅保留高价值核心信息,最终存储空间占用比原始数据小90%以上。
新建会话时自动根据当前用户提问的语义特征,召回匹配度最高的历史上下文片段,自动注入到prompt前缀中,无需手动操作记忆库即可获得带完整背景的AI响应。
原生适配市面上90%以上的主流大模型、代码助手、智能体框架,不需要做定制化二次开发,直接按照官方示例配置3行代码即可完成接入。
所有会话记忆数据全部存储在用户本地设备,全程没有网络上传交互行为,完全杜绝敏感代码、内部项目信息、涉密内容外泄的风险,符合企业级数据安全要求。
配套轻量Web操作界面,可随时查看所有存储的记忆条目,手动编辑、标记重要内容,自定义不同记忆条目的召回权重,灵活适配各类个性化任务需求。
随着会话数据量积累自动优化语义匹配精度,不断学习用户的使用习惯和项目场景特征,长时间使用后上下文召回精准度可达到95%以上。
通过npm或pip一键安装claude-mem依赖包,根据官方文档完成基础参数配置,指定本地记忆库存储路径,绑定你常用的大模型API密钥即可完成部署,全程耗时不超过5分钟。
在你日常使用的AI助手、智能体配置文件中添加claude-mem中间件,参照官方提供的示例代码完成对接,完全不需要修改原有业务逻辑,没有侵入性。
正常使用AI助手处理各类任务,claude-mem在后台低资源占用静默运行,自动记录所有交互内容,经过智能压缩处理后存入本地向量库。
后续任意新建会话时,系统会自动识别当前任务的语义特征,从历史记忆库中召回匹配的相关内容注入prompt,用户无需额外操作即可获得连贯的AI响应。
正在搭建各类智能体应用,需要快速为产品增加持久记忆能力的技术人员。
日常高频使用AI代码助手开发大型项目,反复同步项目背景效率低的程序员群体。
创作长篇小说、系列技术文档、自媒体专栏等需要统一设定的内容从业者。
开发AI类SaaS产品,需要低成本实现跨会话记忆功能的个人开发者。
企业IT运维人员
搭建内部运维、客服类AI智能体,需要记忆大量历史业务规则的企业运维人员。
对数据安全要求极高,不允许会话数据上传第三方平台的涉密场景用户。
把claude-mem接入日常代码助手,开发跨模块大型项目时无需反复同步项目背景,开发效率可提升40%以上。
使用claude-mem快速为自研智能体增加持久记忆能力,节省至少70%的RAG模块从零开发工作量。
在个人AI类SaaS产品中集成claude-mem,极低成本实现跨会话记忆核心功能,大幅提升产品竞争力。
使用claude-mem辅助创作系列技术手册,自动记忆术语定义和章节关联,避免前后内容矛盾。
基于claude-mem搭建专属教学智能体,自动记忆所有学员的提问历史和学习进度,提供个性化辅导服务。
给内部运维智能体接入claude-mem,自动记忆所有服务器配置和历史故障处理方案,大幅提升故障排查效率。
整体项目体积不足10MB,无需部署独立向量数据库、缓存服务,单进程即可运行,几乎不占用系统资源,对接现有项目完全无侵入性。
不需要针对不同大模型做定制化适配,市面上90%以上的主流AI代理、代码助手都可以直接接入使用,适配成本几乎为零。
所有会话数据100%存储在用户本地,全程没有任何网络传输行为,完全杜绝核心代码、企业敏感数据外泄,符合各类等保合规要求。
官方提供开箱即用的一键启动脚本,没有复杂参数配置,普通开发者5分钟即可完成部署使用,不需要掌握RAG、向量数据库等专业技术背景。
采用MIT开源协议发布,所有代码完全公开可审计,没有任何功能阉割、付费墙限制,个人和商业场景都可以免费使用无版权风险。
| 对比项 | claude-mem | AutoGPT记忆插件 | 自定义RAG方案 |
|---|---|---|---|
| 多模型兼容性 | 支持几乎所有主流AI代理 | 仅适配AutoGPT生态 | 需自行开发不同模型适配逻辑 |
| 部署复杂度 | 5分钟完成部署,无额外依赖 | 需搭配AutoGPT环境使用 | 从零开发需数人天工作量 |
| 数据隐私性 | 全量数据本地存储无外传 | 部分数据上传第三方向量平台 | 数据存储位置需自行定义 |
| 使用成本 | 完全开源免费 | 按大模型调用量付费 | 需投入服务器+人力开发成本 |
| 上下文压缩比 | 可达90%以上 | 不足40% | 压缩效果取决于自行选择的模型 |
claude-mem完全基于MIT开源协议发布,所有核心功能100%免费开放,无任何订阅制、按调用量收费的付费限制,普通用户可以自由下载源码二次修改、商用。官方仅面向大型企业用户提供付费增值服务,包含定制化功能开发、私有化部署技术支持、企业级运维保障等专属服务。
我们最近对claude-mem开展了为期一周的深度实测,场景是开发一个React开源工具项目。之前每次隔天继续开发任务,我们都要花十几分钟给AI助手重新同步当前的项目进度、已完成的模块、踩过的坑和约定的代码规范,大量时间都浪费在重复信息同步上。接入claude-mem之后这些重复工作完全消失了,每次打开新的会话它都能自动把我们之前讨论过的架构设计、bug修复记录、代码风格要求全部注入上下文里,生成的代码完全符合前期约定的规范,一周实测下来我们的开发效率直接提升了接近40%。我们还特意测试了它的多模型兼容能力,同时对接了Claude Code和GitHub Copilot两个助手,两者居然可以共享同一套记忆库,两边生成的代码逻辑、风格完全统一,再也没有出现之前不同AI输出结果打架的问题。整个部署过程我们全程只用了不到4分钟,按照官方文档复制了三行配置代码就完成了对接,全程没有踩任何坑。最让我们惊喜的是它的上下文压缩效果,我们连续对话300多轮产生的会话数据,经过智能压缩之后总存储占用不到20MB,远低于我们的预期。
参考资料:
 首页
 AI工具库
 分类
 职业
 跃升榜
 关于
 GitHub


 滇公网安备53252802528134号
 DeepNavi
评论 (0)