
Audimee是一款专注于“歌声转换”的AI音频创作工具,核心目标是让音乐制作人、DJ、词曲作者和内容创作者无需约请多位真人歌手,也能把已有的人声录音快速转换成不同性别、音色、风格与音域的虚拟歌手声音。平台采用浏览器工作方式,支持上传WAV、MP3、FLAC等格式,并提供免版税声音库、自定义声音训练、人声隔离、声音混合、和声制作和Stem分离等能力。
与文本转歌曲式的一站式AI音乐生成器不同,Audimee更强调保留原始旋律、节奏和演唱情绪,再把“嗓音身份”替换为录音室品质的AI模型。它尤其适合已有旋律或干声Demo、希望快速测试不同主唱、制作翻唱人声音轨、补录和声、生成DJ Hook或探索新音色的创作者。第三方评测显示,其声音模型数量已从早期数十种扩展到数百种,付费方案通常包含商业使用权。
我们推荐Audimee,是因为它没有把AI音乐做成“输入提示词、随机出整首歌”的黑盒,而是切中音乐制作中非常具体的人声生产环节:换主唱、做和声、拆干声、训练专属声音和快速A/B测试音色。官网展示了KSHMR、Hugel、Hardwell、Goodboys等电子音乐场景中的使用案例,说明它已进入专业制作人和DJ的工作流。对需要英文流行、Dance、Rock、RnB、Hip Hop等风格人声音轨的创作者来说,Audimee的声库广度、浏览器轻量化流程和付费可商用授权是其核心吸引力。
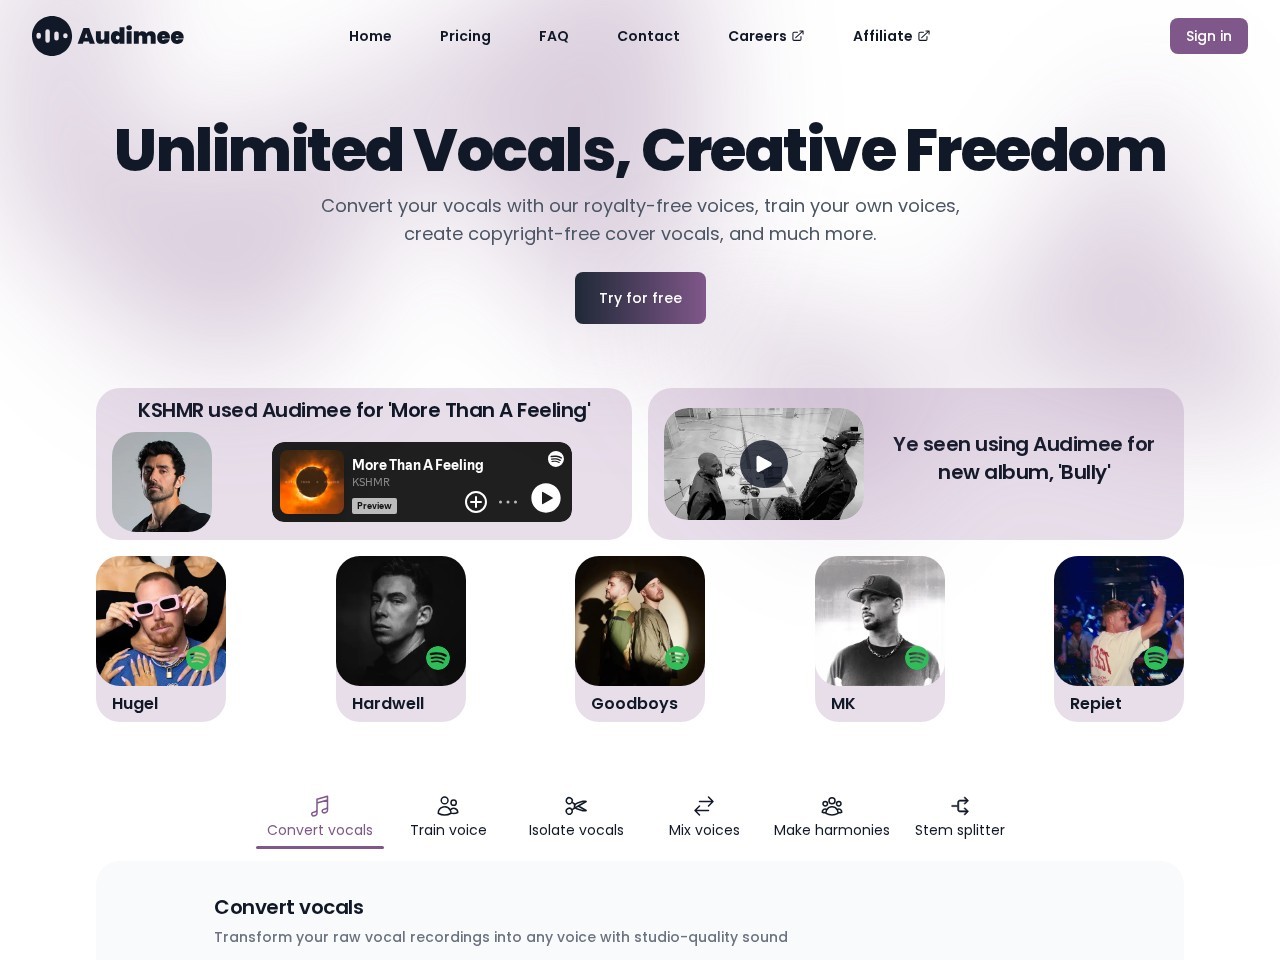 网站截图
Audimee的输出价值主要体现在“同一段演唱、多种声音身份”的快速验证。理想输入应是干净、无混响、无明显伴奏泄漏的人声;输入质量越稳定,转换结果在音准、咬字和情绪保留方面越可靠。
上传一段女声或男声带旋律的干声,选择Pop、Dance或RnB模型,快速得到不同音色的主唱版本,用于比较副歌记忆点。
使用Gritty、Belting、Power等标签的模型,将原本偏轻柔的Demo转换为更有爆发力的摇滚主唱。
为DJ Set或电子单曲制作短句人声、Club Shoutout或Acapella Hook,再导入DAW与鼓组、Bass和合成器对齐。
基于一段主旋律生成多条和声,或把同一旋律交给不同声音模型,形成层次更丰富的翻唱Acapella。
上传已有歌声后选择不同AI模型,在尽量保留原旋律、节奏和情感表达的同时替换嗓音特征。
提供Pop、Dance、Rock、RnB、Hip Hop、Indie、Folk、Jazz等多类声音,部分模型按订阅等级开放。
可上传清晰干声训练专属模型,适合打造固定虚拟歌手、项目角色声音或创作者个人声音资产。
从一条主旋律生成多条和声音轨,并可选择不同声音模型,降低真人录制和后期叠唱成本。
从混音中提取人声、削弱伴奏与背景噪声,便于重混、采样清理、翻唱制作和再次转换。
将两个或多个声音模型进行融合,创造介于不同性别、音色和风格之间的混合型虚拟嗓音。
在转换前对旋律音高进行修整,改善跑音、滑音和音符起始位置,使最终输出更接近录音室成品。
无需安装大型插件或本地模型,打开网页即可上传、转换、试听和下载,适合轻量化制作流程。
录制或导出干净人声,尽量避免混响、延迟、伴奏泄漏、爆音和过度压缩,可使用WAV、MP3或FLAC。
在Audimee中上传音频,试听时间轴与歌词对齐情况,必要时使用音高编辑工具修正明显不准的音符。
根据曲风、性别、音域、真假声和力量感筛选模型,可先用免费或基础模型测试,再切换高级模型精修。
生成转换结果后,与原始旋律和伴奏一起试听;可尝试多个模型或混合声音,满意后导出人声音轨进入DAW后期。
需要在编曲阶段快速测试不同主唱音色,减少约歌手、等待录音和反复返工的时间成本。
可制作Club Intro、Vocal Chop、Acapella Hook和特色短句,与Drop、Build-up或Live Set结合。
即使本人声音不适合最终发行,也能用相对准确的旋律Demo演示作品,让版权投递和合作沟通更直观。
适合把自己的演唱转换为多种免版税声音,并通过和声与隔离功能生成更完整的翻唱版本。
可制作英文Vocal Hook、广告短句、频道标识音或BGM中的人声片段,增强内容记忆点。
可为角色、预告片或互动内容测试不同歌声,但正式项目仍需核对素材授权与声音来源。
可训练固定声音模型,持续输出同一“声音角色”的演唱内容,建立可复用的数字声音资产。
建议把Audimee放在编曲后半段或Demo验证阶段:先用干声测3到5个模型,再根据曲风选择最终主唱与和声。
适合制作8小节以内的Hook和Acapella,再在Ableton Live、FL Studio等DAW中做Vocal Chop、侧链和效果处理。
可将固定频道口号或栏目名称制作为统一声音标识,但应优先选择付费授权模型,避免商用风险。
在脚本阶段预留人声Hook位置,先用Audimee快速出样,确认节奏和情绪后再进入剪辑、字幕与封面制作。
可把它当作备选声音处理工具,而不是替代专业修音与混音;输入干声质量和后续EQ、压缩、空间处理仍决定成品上限。
建议从免费计划开始验证英文咬字和音域匹配,确认项目有发布或变现需求后再升级到含商业授权的订阅。
它保留用户输入的旋律与演唱框架,结果更可控,适合已经有音乐想法的创作者,而不是从零寻找随机灵感。
第三方资料显示其可提供数百种AI声音,覆盖流行、舞曲、摇滚、RnB、说唱、民谣、爵士等多种风格。
转换、修音、和声、隔离、混合与训练集中在同一网页工作流,减少在多个音频工具之间反复导出导入。
多个第三方评测均提到付费计划包含商业使用权,这对音乐发行、广告、短视频和客户项目至关重要。
官网展示KSHMR等专业音乐人案例,也出现Hugel、Hardwell、Goodboys等Dance领域名字,增强了专业可信度。
自定义模型训练让创作者不必自行搭建深度学习环境,也能拥有可反复调用的虚拟歌手声音。
| 对比项 | Audimee | Kits AI | Emvoice |
|---|---|---|---|
| 产品定位 | AI歌声转换、自定义模型与人声处理 | AI声音库、人声转换与音乐音频工具 | DAW内歌声合成插件 |
| 核心输入 | 已有干声或人声音频 | 人声音频或平台声音资产 | MIDI音符与歌词 |
| 使用方式 | 浏览器网页,无需安装 | 以网页工作流为主 | VST/AU/AAX插件,依赖DAW |
| 声音风格 | 数百种英文/欧美风格模型,曲风覆盖广 | 声音模型丰富,偏音乐制作与创作者生态 | 精细可控,但声音库与插件体系相对独立 |
| 自定义训练 | 支持 | 支持部分声音克隆/定制能力 | 通常不以用户自助训练为主 |
| 适合任务 | 快速换主唱、翻唱、和声、DJ Hook | 声音转换、音乐制作、音频协作 | 通过MICK编写可编辑演唱 |
| 价格门槛 | 免费试用,订阅约12美元/月起 | 依功能与授权订阅变化 | 插件/声音付费,入门成本相对明确 |
Audimee采用Freemium模式。免费计划适合试听和个人测试,但通常会限制可用声音、每月生成时长、导出质量或商业授权。根据2026年第三方工具导航与评测信息,付费订阅大致分为Starter约12美元/月、Professional约25美元/月、Ultimate约49美元/月,更高等级提供更多声音模型、处理时长、导出规格和高级功能;企业版可通过hi@audimee.com联系。价格、分钟数和授权条款可能随官网调整,正式商用前应以Audimee官方Pricing与Terms页面为准。
我这次以“已有一段英文人声Demo”的路径测试Audimee。准备素材时,我特意选择了一段没有混响、没有伴奏的干声,旋律集中在中高音区,长度约30秒。上传后,页面的工作流比较直观:先确认音频波形,再选择声音模型,随后生成并试听。整个过程不需要下载插件,也没有复杂的本地显卡或模型配置,对不想折腾RVC环境的创作者很友好。
第一轮我选择偏Pop和Dance的女声模型,生成后最明显的感受是,原旋律的节奏轮廓和大部分音高变化被保留下来,声音身份确实发生了明显变化,而不是简单升调。副歌部分的气息和颗粒感比较自然,适合先做Demo方向判断。第二轮我尝试Rock风格的力量型模型,高音区的厚度增强,但在强Belting段落,如果原素材本身音准或起音不够干净,输出会放大这些问题。这也验证了一点:Audimee不是“烂素材修复魔法”,干声质量仍然是上限。
和声功能适合快速搭建副歌厚度。用同一段主旋律生成二部、三部和声后,直接与伴奏叠加,能很快听到接近成品的层次。不过正式混音时我仍建议把导出的人声放进DAW重新处理EQ、压缩、混响和定位,因为网页端生成结果更像“可用的声音素材”,而不是已经完成混音的最终母带。人声隔离功能对简单编曲有效,但在复杂电子音色与人声频率重叠较多时,仍可能出现残留 artifacts。
综合来看,我认为Audimee最适合三类任务:一是制作人快速A/B测试不同主唱;二是DJ和电子音乐人制作英文Vocal Hook;三是翻唱或短视频创作者生成免版税人声音轨。它的短板也很明确:中文咬字不是主场,不能从歌词直接生成编曲完整的歌曲,复杂项目仍需专业DAW后制。若你做的是英文流行、Dance或DJ向项目,并且愿意认真准备干声,它的效率提升会非常明显。
参考资料:
 首页
 AI工具库
 分类
 职业
 跃升榜
 关于


 滇公网安备53252802528134号
 DeepNavi
评论 (0)